Jarana
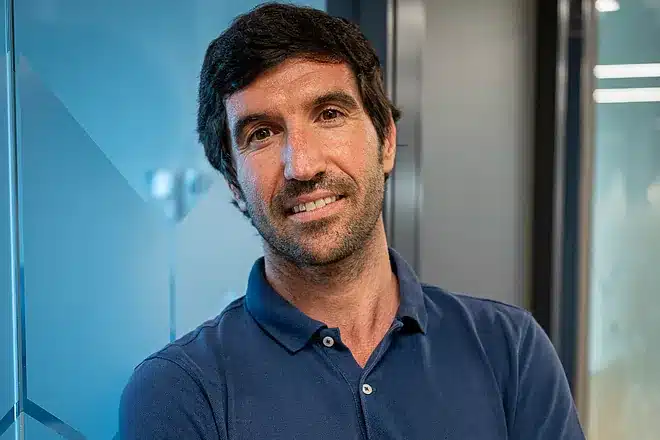
Revolut ha nombrado a Santiago Pérez Olano nuevo director general de su filial en España, en un momento de fuerte crecimiento de la entidad en el mercado nacional. Pérez Olano se incorpora procedente de Remitly, donde fue máximo responsable para Europa, Oriente Medio y Asia (EMEA) y lideró la expansión de la plataforma de transferencias digitales en Europa. Anteriormente, desarrolló parte de su trayectoria en Expedia Group, ocupando posiciones de responsabilidad en Marketing & Growth y Alianzas Estratégicas para EMEA y Latinoamérica. Licenciado en Administración y Dirección de Empresas por ESADE y MBA por London Business School, cuenta con una amplia experiencia en negocios digitales, crecimiento y expansión internacional. En su nueva posición trabajará junto a Ignacio Zunzunegui, responsable de crecimiento de Revolut para el sur de Europa, Latinoamérica y Estados Unidos, para continuar impulsando el negocio de la entidad en España, donde ya supera los 6,3 millones de clientes y los 1.800 empleados.
27 Agosto 2026
ESG
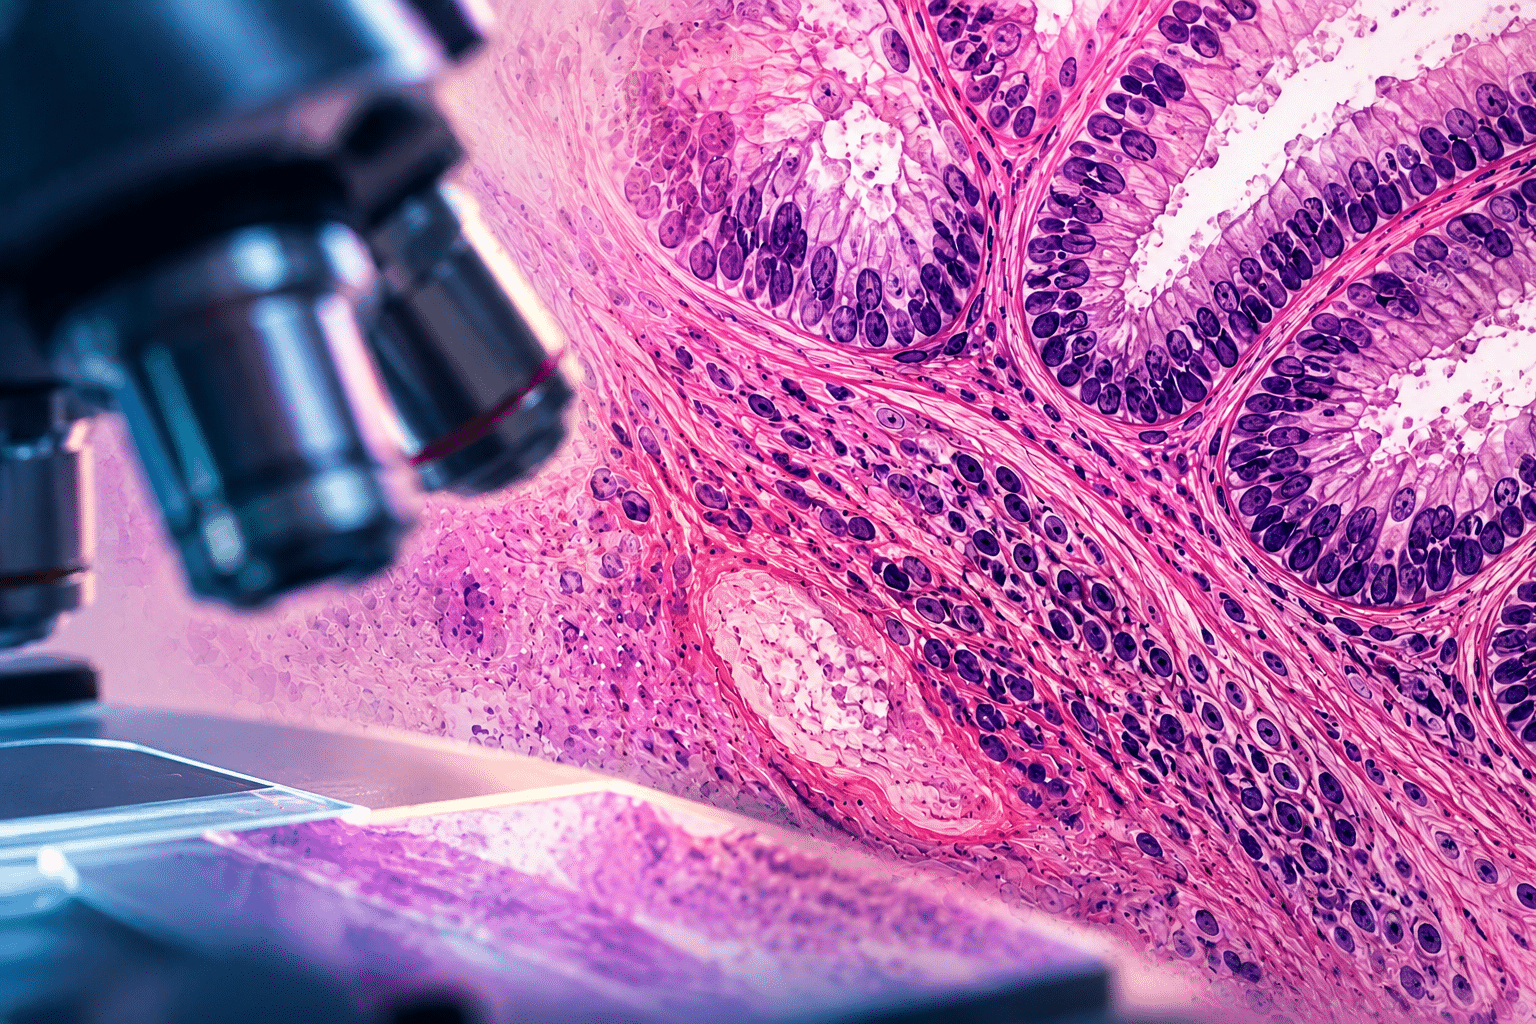
Microsoft Research y Paige han desarrollado PRISM2, un modelo fundacional que combina imágenes de tejidos con el lenguaje procedente de informes anatomopatológicos reales. En las pruebas realizadas, el sistema igualó o superó a modelos especializados en diferentes tareas relacionadas con la detección del cáncer. La inteligencia artificial lleva tiempo demostrando su capacidad para identificar patrones en imágenes médicas. Sin embargo, trasladar estos avances a la anatomía patológica presenta una dificultad importante: muchos de los sistemas actuales están diseñados para resolver una única tarea y necesitan ser desarrollados o adaptados específicamente cuando cambia la aplicación. Una nueva investigación de Microsoft Research y Paige, actualmente parte de Tempus, plantea una alternativa. Los investigadores han desarrollado PRISM2, un modelo fundacional de inteligencia artificial concebido para abordar diferentes tareas de anatomía patológica desde una misma arquitectura. La investigación, publicada recientemente en Nature Medicine, explora además una idea especialmente relevante para el futuro de la IA médica: enseñar a los modelos no solo a interpretar lo que aparece en una imagen, sino también a comprender el lenguaje que los especialistas utilizan para describirlo. Imágenes médicas y lenguaje en un mismo modelo La anatomía patológica tiene un componente visual evidente. Los especialistas examinan muestras de tejidos para identificar alteraciones y establecer diagnósticos que posteriormente pueden resultar determinantes para decidir el tratamiento de un paciente. Pero esta disciplina también genera una enorme cantidad de información textual a través de los informes anatomopatológicos. PRISM2 busca aprovechar ambas fuentes. Durante su entrenamiento, los investigadores relacionaron imágenes de tejidos con información procedente de informes reales de anatomía patológica. A partir de este material generaron millones de ejemplos en formato de preguntas y respuestas para enseñar al modelo a conectar los patrones visuales presentes en las muestras con el lenguaje empleado por los profesionales durante el proceso diagnóstico. Este enfoque permite que el sistema pueda trabajar únicamente con imágenes o combinar información visual y textual. Además, los investigadores pueden interactuar con el modelo mediante instrucciones o preguntas, en lugar de depender exclusivamente de herramientas desarrolladas para una función concreta. Un único modelo para diferentes tipos de cáncer Uno de los aspectos más destacados de la investigación aparece en sus resultados. Durante las pruebas, PRISM2 igualó o superó el rendimiento de sistemas especializados de detección de cáncer en diferentes benchmarks, incluyendo tareas relacionadas con el cáncer de próstata, el cáncer de mama y la detección de metástasis del cáncer de mama en los ganglios linfáticos. La diferencia está en que estos resultados se consiguieron sin desarrollar un modelo independiente para cada una de esas funciones. Esta capacidad podría facilitar en el futuro el desarrollo de nuevas herramientas de inteligencia artificial aplicadas a la anatomía patológica, ya que los investigadores podrían partir de un mismo modelo fundacional y adaptarlo a diferentes casos de uso, en lugar de comenzar desde cero cada vez que quieran resolver un nuevo problema. De reconocer imágenes a comprender su contexto Los modelos fundacionales también están transformando el desarrollo de la IA médica. Muchas aproximaciones anteriores en anatomía patológica se habían centrado principalmente en enseñar a los algoritmos a reconocer características visuales de las muestras. PRISM2 incorpora desde su diseño la relación entre esas imágenes y el lenguaje clínico utilizado para interpretarlas. La idea es especialmente significativa porque una imagen médica rara vez existe de manera aislada dentro de la práctica clínica. Su interpretación se acompaña de información, observaciones y conclusiones que proporcionan contexto sobre lo que el especialista está observando. Al conectar ambos mundos, los investigadores buscan que la IA pueda desarrollar representaciones más completas de la información anatomopatológica y servir como base para futuras aplicaciones. La IA médica avanza hacia modelos más versátiles El desarrollo de PRISM2 refleja una tendencia que se extiende mucho más allá de la anatomía patológica: el paso de sistemas de inteligencia artificial extremadamente especializados hacia modelos fundacionales capaces de abordar diferentes tareas a partir de una misma base tecnológica. En el ámbito sanitario, esta evolución podría acelerar la investigación y reducir la necesidad de construir soluciones completamente independientes para cada problema clínico. No obstante, PRISM2 se presenta actualmente como una herramienta destinada a investigación y desarrollo, no como sustituto del criterio de los profesionales sanitarios. Microsoft y sus colaboradores han hecho públicos los pesos completos del modelo para uso investigador, permitiendo que la comunidad científica pueda experimentar con esta tecnología y estudiar nuevas aplicaciones. La investigación abre así una nueva vía para la IA aplicada a la medicina: sistemas capaces no solo de detectar patrones en una muestra de tejido, sino de empezar a relacionarlos con el mismo lenguaje especializado que utilizan los profesionales para interpretarlos.
26 Agosto 2026
Jarana
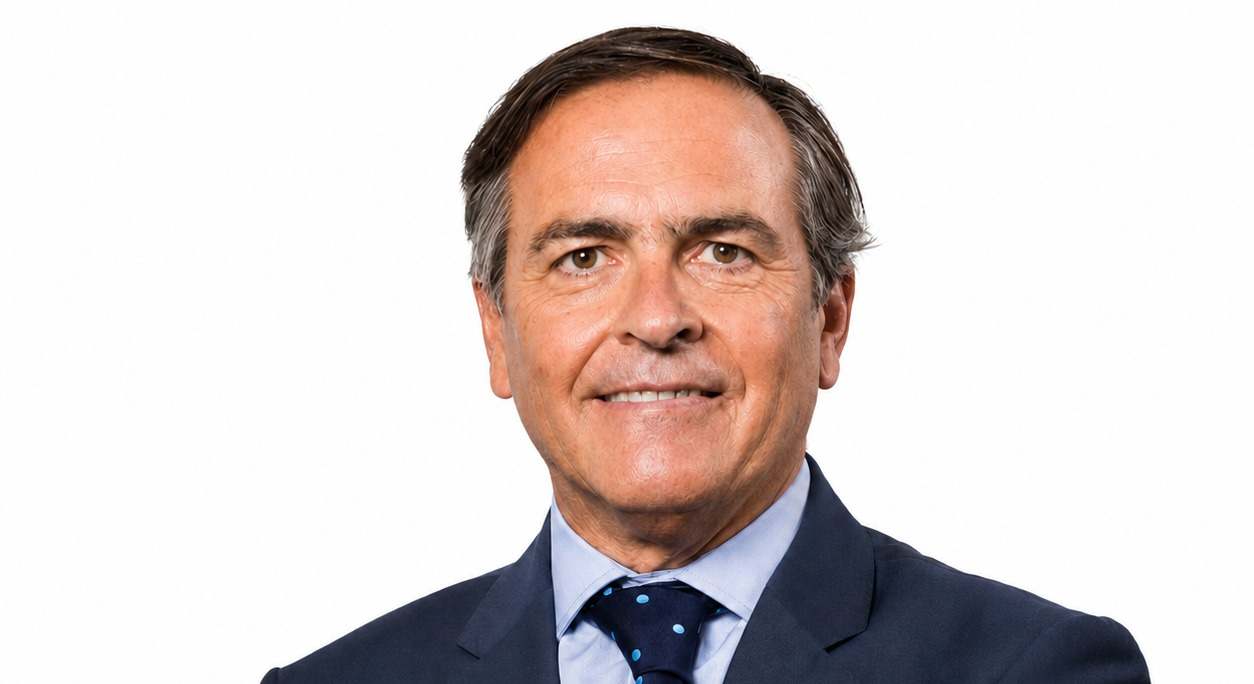
Tubacex ha anunciado el nombramiento de Ignacio Mataix Entero como nuevo presidente no ejecutivo de la compañía. La designación, aprobada por el Consejo de Administración, será efectiva a partir del 1 de septiembre de 2026. Mataix, quien fue consejero delegado de Indra, sustituirá en el cargo a Manuel Moreu Munaiz, que dejará la presidencia de la compañía en esa misma fecha. Con esta incorporación, Tubacex refuerza su órgano de gobierno con un perfil de amplia trayectoria en la industria y la gestión empresarial, en una nueva etapa para el grupo.
26 Agosto 2026
Jarana
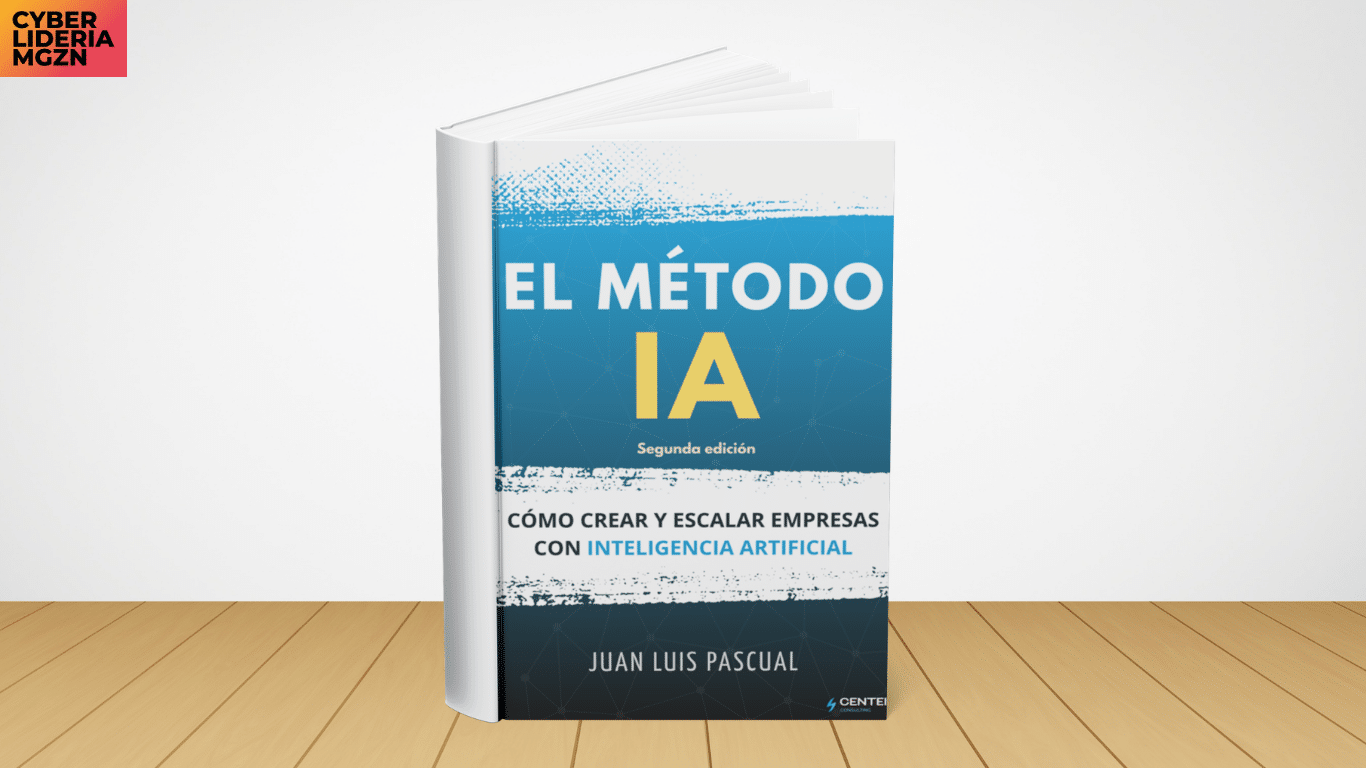
En El Método IA. Cómo crear y escalar empresas con Inteligencia Artificial, Juan Luis Pascual propone una hoja de ruta para que las organizaciones conviertan la IA en una verdadera capacidad de negocio. El libro aborda cómo pasar de los pilotos aislados a iniciativas escalables, medibles y alineadas con la estrategia, combinando tecnología, talento, gobernanza y liderazgo. Una guía para directivos que buscan que la IA deje de ser una promesa y empiece a generar valor real. Autor: Juan Luis Pascual Abad
26 Agosto 2026
Eventos
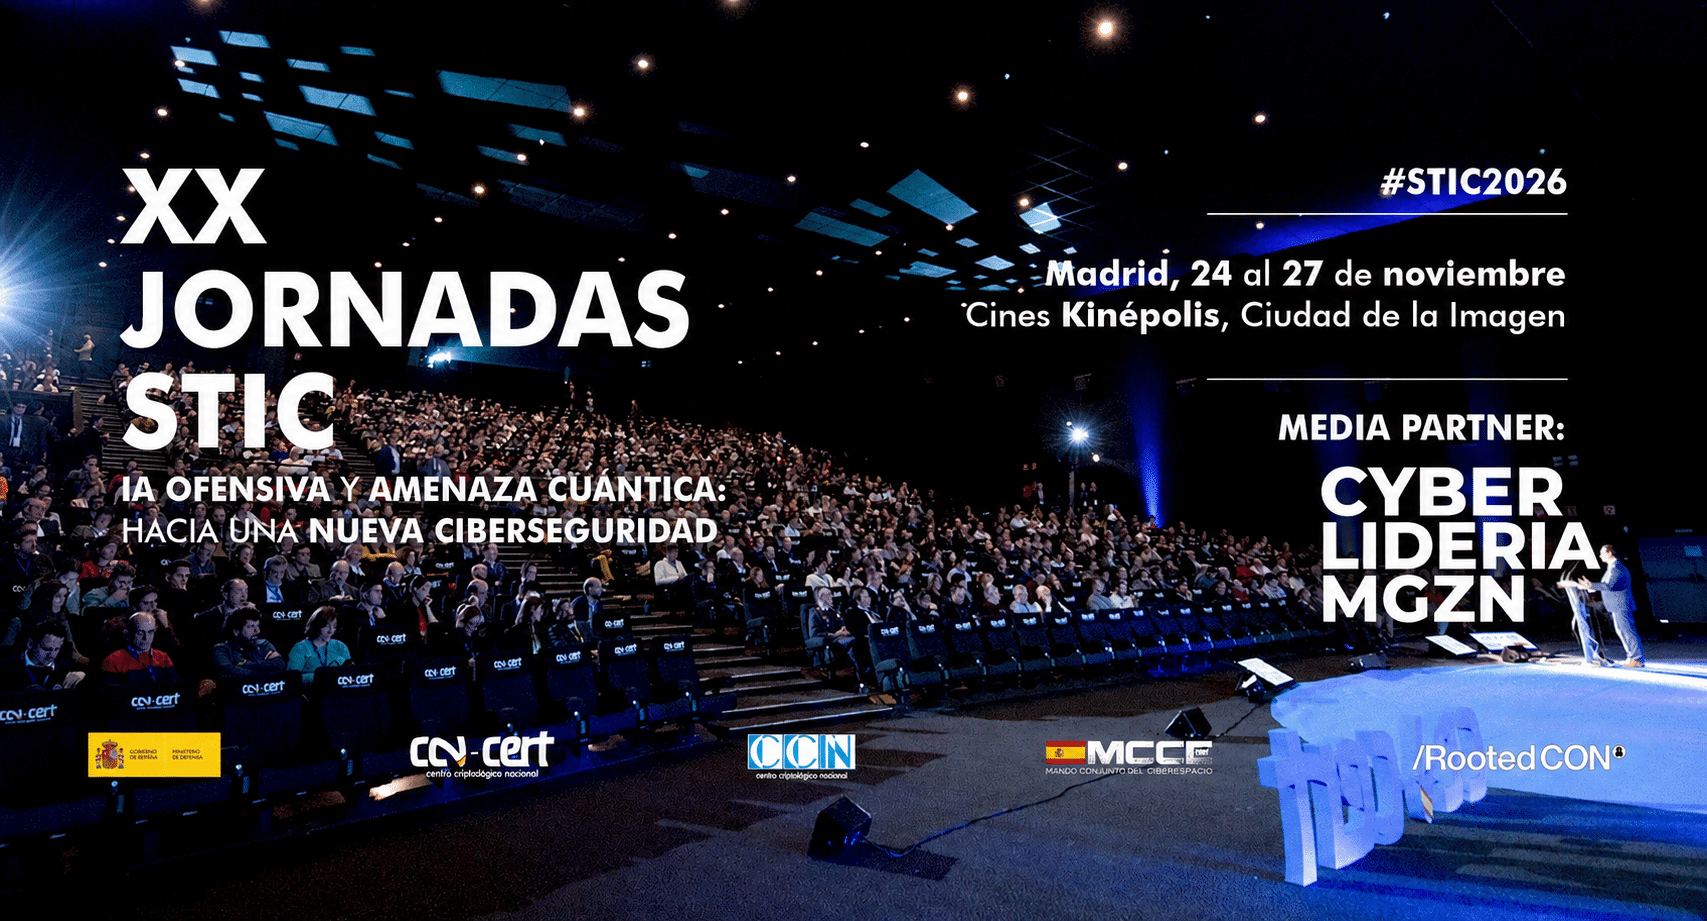
Del 24 al 27 de noviembre, Madrid se convertirá en uno de los principales puntos de encuentro de la comunidad de ciberseguridad y ciberdefensa con la celebración conjunta de las XX Jornadas STIC, las VIII Jornadas de Ciberdefensa ESPDEF-CERT y el Congreso RootedCON. CyberLideria MGZN participa como Media Partner del encuentro. La ciberseguridad afronta una nueva etapa marcada por la rápida evolución de la inteligencia artificial, el desarrollo de nuevas capacidades ofensivas y la llegada de tecnologías capaces de transformar los actuales modelos de protección. Bajo el lema “IA ofensiva y amenaza cuántica: hacia una nueva ciberseguridad”, las Jornadas STIC regresan a Madrid del 24 al 27 de noviembre de 2026 con una edición especialmente significativa. El encuentro, que se celebrará en los Cines Kinépolis Ciudad de la Imagen de Madrid, alcanzará este año su 20ª edición, consolidando dos décadas dedicadas al intercambio de conocimiento y al fortalecimiento de las capacidades nacionales en materia de ciberseguridad. Además, 2026 marcará un hito para el sector: por primera vez, las XX Jornadas STIC, las VIII Jornadas de Ciberdefensa ESPDEF-CERT y el Congreso RootedCON confluirán en una misma convocatoria, organizada por el Centro Criptológico Nacional (CCN), el Mando Conjunto del Ciberespacio (MCCE) y RootedCON. Cuatro días para analizar la nueva realidad de las amenazas Durante cuatro jornadas, profesionales y expertos de la Administración Pública, las Fuerzas Armadas, la empresa privada, la industria tecnológica y el ámbito académico compartirán experiencias, investigaciones y estrategias para afrontar un escenario digital cada vez más complejo. El programa combinará conferencias, mesas redondas, talleres especializados, sesiones prácticas y espacios de colaboración, con especial atención a la aplicación técnica del conocimiento y al desarrollo de nuevas capacidades de prevención, detección y respuesta. Entre las áreas previstas se encuentran la inteligencia artificial, el cibercrimen, las amenazas y tendencias emergentes, los SOC, el Esquema Nacional de Seguridad (ENS), las operaciones militares en el ciberespacio, la protección de infraestructuras críticas y servicios esenciales, la inteligencia de amenazas y la resiliencia operativa. La programación incluirá además actividades de Rooted Labs, sesiones vinculadas a realidad virtual y diferentes ponencias especializadas y magistrales. IA ofensiva y computación cuántica, en el centro del debate El lema elegido para #STIC2026 refleja dos de los grandes vectores de transformación que afronta actualmente la industria. Por un lado, la inteligencia artificial está modificando tanto las capacidades defensivas como las herramientas disponibles para los atacantes. Por otro, la evolución de la computación cuántica obliga a anticipar nuevos escenarios relacionados con la protección de la información, la criptografía y la seguridad de las infraestructuras digitales. La cita abordará estos retos dentro de un contexto tecnológico y geopolítico de creciente complejidad, con el objetivo de reforzar la cooperación entre instituciones, empresas, profesionales y comunidad especializada. Una cita que reunió a más de 16.200 asistentes en 2025 La dimensión alcanzada por las Jornadas STIC quedó reflejada en su edición anterior. En 2025, el encuentro congregó a más de 16.200 asistentes, de los cuales más de 9.500 participaron presencialmente, con representación procedente de más de 42 países. Además, la cita contó con el respaldo de 113 empresas patrocinadoras y colaboradoras, cifras que evidencian el creciente peso del encuentro dentro del ecosistema nacional e internacional de la ciberseguridad. En su vigésimo aniversario, las Jornadas STIC buscan reforzar ese papel como espacio de conexión entre el sector público y privado, las Fuerzas Armadas, la industria, el mundo académico y los profesionales encargados de proteger el ciberespacio. CyberLideria MGZN será Media Partner de las XX Jornadas STIC 2026, acompañando una edición que pondrá el foco en los desafíos que están definiendo la próxima generación de la ciberseguridad. Más información en la página web oficial
25 Agosto 2026
Rincón del CISO
La extracción automatizada de información de Internet se ha convertido en una herramienta habitual para analizar mercados y detectar tendencias, pero su uso también plantea desafíos en materia de privacidad, protección de datos y ciberseguridad. ESET advierte de que la información accesible en la Red puede ser utilizada para construir ataques cada vez más personalizados. Internet contiene una enorme cantidad de información al alcance de cualquier usuario. Precios, perfiles profesionales, correos electrónicos, publicaciones, noticias o datos corporativos pueden consultarse públicamente y, mediante herramientas automatizadas, recopilarse y analizarse a gran escala en cuestión de minutos. Esta práctica, conocida como web scraping, ofrece importantes posibilidades para las empresas, pero también está abriendo nuevos frentes en materia de seguridad y privacidad. ESET alerta de que las mismas tecnologías utilizadas legítimamente para analizar mercados pueden servir a los ciberdelincuentes para recopilar información con la que preparar fraudes y ataques de ingeniería social. Del análisis de mercado a la inteligencia sobre personas El web scraping consiste en automatizar la extracción de información disponible en páginas web, redes sociales, plataformas de comercio electrónico y otros servicios digitales. También puede formar parte de procesos de inteligencia de fuentes abiertas, conocidos como OSINT. En el entorno empresarial, sus aplicaciones son numerosas. Las organizaciones pueden utilizar estas técnicas para monitorizar precios de competidores, identificar tendencias, analizar conversaciones digitales, estudiar productos o seguir las noticias de un determinado sector. Sin embargo, la capacidad de recopilar miles o millones de datos de forma automatizada también puede utilizarse con objetivos maliciosos. Un atacante podría rastrear diferentes fuentes públicas para localizar nombres de empleados, cargos, direcciones de correo electrónico, teléfonos, relaciones profesionales o información sobre una compañía. Una vez agregados y relacionados, esos datos permiten construir perfiles mucho más completos de empleados y directivos. El resultado es especialmente relevante para la ciberseguridad: cuanto mayor sea la información disponible sobre una víctima, más creíble puede resultar un intento de phishing, spear phishing, fraude o suplantación de identidad. El interés económico por estas tecnologías continúa, además, aumentando. Según datos de Grand View Research citados por ESET, el mercado mundial de datos alternativos obtenidos mediante web scraping alcanzó los 2.538,9 millones de dólares en 2025 y podría registrar una tasa de crecimiento anual compuesta del 36,9% hasta 2033. Un dato público no es necesariamente un dato de libre uso Uno de los principales errores alrededor del scraping consiste en asumir que cualquier información accesible en Internet puede recopilarse y reutilizarse sin restricciones. No necesariamente. La legalidad del web scraping depende de factores como la naturaleza de la información extraída, el propósito de su recopilación, el tratamiento posterior de esos datos y las normas aplicables en cada caso. La situación cobra especial relevancia cuando se recopilan datos personales, pero también cuando existen derechos de propiedad intelectual o limitaciones legales y contractuales sobre determinados contenidos. En España, la Agencia Española de Protección de Datos considera que la recopilación mediante scraping de información personal constituye un tratamiento de datos y, por tanto, queda sujeta a la normativa correspondiente. Esta interpretación también se refleja en las directrices europeas sobre web scraping adoptadas en julio de 2026, que sitúan bajo el ámbito del RGPD operaciones como la recopilación, almacenamiento, organización o recuperación automatizada de datos personales. Josep Albors, responsable de Investigación y Concienciación de ESET España, señala que la accesibilidad de una información no elimina las responsabilidades asociadas a su utilización. Las organizaciones deben valorar qué información recopilan, para qué la necesitan y qué tratamiento realizarán posteriormente, especialmente cuando existen datos personales o sensibles. El problema de la escala La automatización introduce otro elemento clave: la capacidad de recopilar información a gran escala. Buscar manualmente los datos de cientos de empleados exigiría tiempo y recursos. Un sistema automatizado puede rastrear numerosas páginas y fuentes públicas, estructurar los resultados y relacionarlos en mucho menos tiempo. Esta capacidad permite que pequeñas piezas de información aparentemente inocuas adquieran valor cuando se combinan. Un nombre, un puesto de trabajo, una dirección de correo electrónico y una publicación en una red social pueden ser suficientes para crear un mensaje fraudulento adaptado a una persona concreta. El scraping puede convertirse así en una primera fase de reconocimiento para ataques posteriores. Las consecuencias para las organizaciones tampoco se limitan al robo de información. Un número elevado de solicitudes automatizadas puede aumentar el consumo de recursos de los servidores, reducir el rendimiento de una web e incluso afectar temporalmente a su disponibilidad. A ello se añaden posibles daños económicos, reputacionales y legales cuando información relacionada con empleados, clientes o la propia organización termina siendo utilizada fraudulentamente. Cómo reducir el scraping malicioso Eliminar por completo estas prácticas resulta complicado cuando una organización necesita mantener determinada información accesible en Internet. Por ello, ESET apuesta por una estrategia basada en diferentes capas de protección. Entre las principales medidas se encuentra la monitorización del tráfico para identificar direcciones IP o comportamientos con un volumen anormal de peticiones. Aplicar límites de velocidad o bloqueos temporales puede dificultar la recopilación masiva, aunque el uso de proxys y VPN obliga a combinar esta defensa con otros mecanismos. También resulta importante configurar adecuadamente el archivo robots.txt, utilizado para indicar a los rastreadores qué partes de una web deberían explorar. No obstante, se trata de una indicación y no de una medida de seguridad: un scraper malicioso puede ignorarla, por lo que nunca debería emplearse como protección para información sensible. El análisis de agentes de usuario, frecuencia de solicitudes y patrones de navegación permite asimismo detectar actividad automatizada. Herramientas como los firewalls de aplicaciones web (WAF) pueden añadir una capa adicional para identificar y bloquear tráfico sospechoso. En formularios, buscadores u otros puntos especialmente sensibles, los sistemas CAPTCHA pueden dificultar la actividad masiva de bots. Otra alternativa son los honeypots, recursos diseñados como señuelos que permiten detectar sistemas automatizados y analizar su comportamiento sin comprometer activos reales. Pero una de las medidas más importantes no es estrictamente tecnológica: reducir la cantidad de información innecesaria disponible públicamente. Las organizaciones deberían revisar periódicamente qué datos corporativos y personales pueden encontrarse en Internet y limitar su exposición a aquellos que sean realmente necesarios. La formación de los empleados también desempeña un papel relevante, ya que publicar de forma innecesaria teléfonos, correos electrónicos u otra información profesional puede proporcionar nuevas piezas para ataques dirigidos. Menos exposición, menos información para el atacante No existe una única tecnología capaz de impedir todas las modalidades de web scraping. La protección pasa por combinar controles técnicos, monitorización y una política más estricta sobre la información que una organización hace pública. En un escenario en el que los ciberdelincuentes pueden automatizar la recopilación y el análisis de grandes cantidades de datos, la superficie de exposición de una empresa ya no está formada únicamente por sus sistemas y aplicaciones, sino también por toda la información que deja accesible en Internet. El desafío, por tanto, no consiste únicamente en decidir qué puede publicarse, sino también en comprender qué podría hacer un tercero con esos datos una vez recopilados, relacionados y analizados a escala.
25 Agosto 2026
Jarana
Banco Sabadell ha anunciado el nombramiento de Adela Martín Ruiz como nueva directora de Banca Privada. La directiva se incorporará a la entidad en los próximos meses para liderar esta área estratégica. Con esta incorporación, el banco busca reforzar su propuesta de valor para los clientes de banca privada y avanzar en su objetivo de consolidarse como el banco de referencia en la relación con sus clientes en España. La llegada de Martín Ruiz se enmarca en la estrategia de Banco Sabadell para impulsar el crecimiento y el desarrollo de su negocio de Banca Privada mediante un liderazgo orientado al cliente y a la excelencia en el servicio.
25 Agosto 2026
Jarana
Javier Ibáñez Matía ha sido nombrado presidente del Consejo de Administración de Bupa México, filial de Bupa en el país y matriz de Sanitas, que cuenta con más de 422.000 asegurados y una red asistencial propia formada por Vitamédica y el Hospital Bité Médica. Ibáñez compaginará esta nueva responsabilidad con su actual cargo como director general de Sanitas Seguros y consejero de la compañía, reforzando así su papel dentro del grupo tanto en España como en México. Con más de 15 años de trayectoria en Bupa, ha ocupado diferentes puestos de responsabilidad, entre ellos responsable de Productos y Desarrollo de Negocio, director regional de la zona Norte y, desde 2021, director general de Sanitas Seguros. Durante esta última etapa, la compañía ha superado los tres millones de asegurados y ha impulsado la consolidación de Blua, el ecosistema de salud digital de Sanitas, disponible ya para toda su cartera de clientes. El nombramiento se produce tras el anuncio de la incorporación de Israel Ranero como nuevo director general de Bupa México, cargo que asumirá el próximo 1 de septiembre, sujeto a la correspondiente aprobación regulatoria.
24 Agosto 2026
ESG
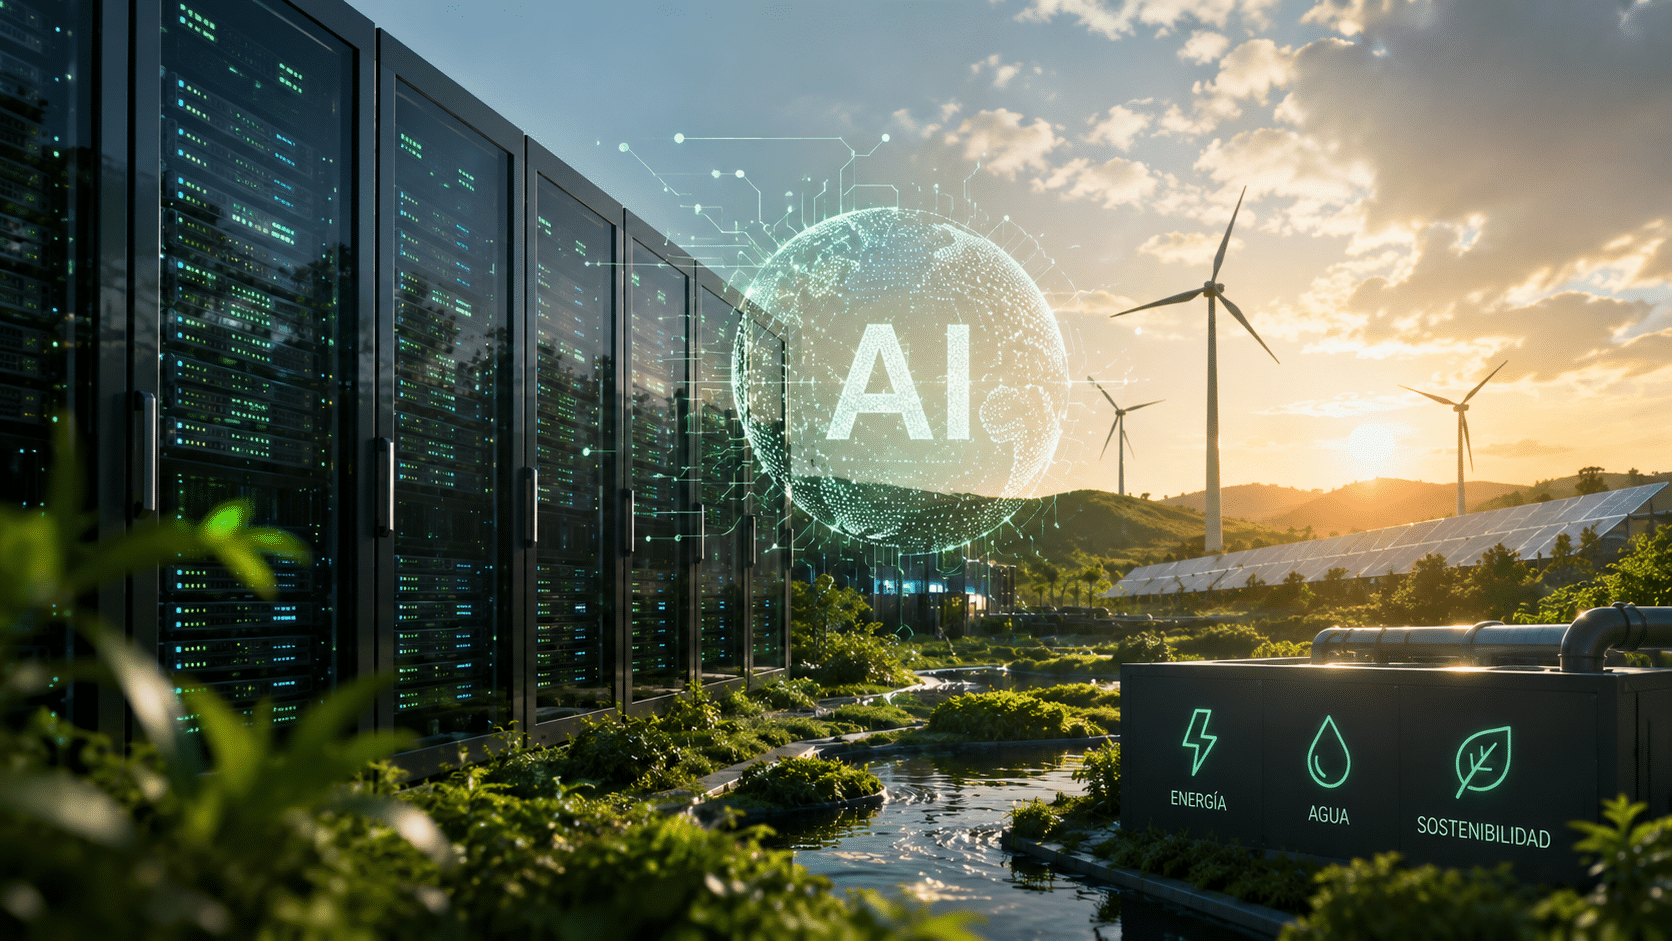
La inteligencia artificial está transformando la forma en la que trabajan las empresas, automatizan procesos y toman decisiones. Sin embargo, detrás de cada modelo generativo, asistente virtual o agente inteligente existe una infraestructura tecnológica cuyo crecimiento plantea un importante desafío ambiental. El auge de la IA está impulsando una expansión sin precedentes de los centros de datos, instalaciones que requieren enormes cantidades de electricidad y sistemas de refrigeración para mantener operativos miles de servidores de alto rendimiento. Mientras la innovación avanza a gran velocidad, el debate sobre el impacto energético de esta nueva revolución tecnológica cobra cada vez más relevancia. Un consumo energético en constante crecimiento El entrenamiento y la ejecución de modelos de inteligencia artificial demandan una capacidad de cálculo muy superior a la de aplicaciones tradicionales. Esto se traduce en un incremento del consumo eléctrico y en la necesidad de ampliar infraestructuras capaces de soportar cargas de trabajo cada vez mayores. Las grandes tecnológicas están invirtiendo miles de millones de euros en nuevos centros de datos para responder a la creciente demanda de servicios basados en IA. El desafío de la refrigeración Además del consumo energético, uno de los principales retos reside en la refrigeración de estas instalaciones. Los servidores generan grandes cantidades de calor que deben disiparse de forma continua para garantizar su funcionamiento. Dependiendo de la tecnología utilizada, este proceso puede requerir importantes volúmenes de agua o sofisticados sistemas de climatización, especialmente durante los meses de verano. La ubicación de los centros de datos y el acceso a fuentes de energía renovable se están convirtiendo en factores estratégicos para reducir su impacto ambiental. IA responsable también significa sostenibilidad Cada vez más empresas incorporan criterios ambientales al desarrollo y despliegue de soluciones basadas en inteligencia artificial. Optimizar algoritmos, mejorar la eficiencia de los modelos, reducir el consumo computacional o aprovechar energías renovables forman parte de una estrategia que busca equilibrar innovación y sostenibilidad. El concepto de IA responsable ya no se limita a la ética, la transparencia o la gobernanza de los datos; también incluye el uso eficiente de los recursos naturales. El nuevo reto para las organizaciones La creciente digitalización convierte a la infraestructura tecnológica en un elemento clave dentro de las estrategias ESG. Medir el impacto ambiental de la inteligencia artificial, exigir eficiencia a los proveedores cloud e incorporar indicadores de sostenibilidad tecnológica serán aspectos cada vez más relevantes para las empresas que quieran avanzar hacia una transformación digital realmente responsable. La inteligencia artificial promete revolucionar todos los sectores, pero su éxito a largo plazo dependerá también de la capacidad para hacer compatible la innovación con la sostenibilidad.
21 Agosto 2026
Jarana
MAPFRE Tech ha incorporado a Nacho Mayero Mariscal de Gante como nuevo director de Administración y Finanzas. Tras cerca de 16 años en PwC España, donde desarrolló su carrera participando en proyectos de transformación y consultoría, Mayero inicia una nueva etapa profesional con el objetivo de impulsar la gestión económica de la tecnología y contribuir a la evolución de la organización, conectando estrategia, finanzas y transformación. Con este nombramiento, MAPFRE Tech refuerza su apuesta por una gestión financiera orientada a maximizar el valor de la innovación tecnológica.
21 Agosto 2026
Rincón del CISO
La proliferación de agentes inteligentes obliga a replantear la gestión de identidades y accesos en las organizaciones La llegada de los agentes de inteligencia artificial está transformando la forma en la que las empresas automatizan procesos. Sin embargo, mientras buena parte del debate gira en torno a su productividad o capacidad de decisión, existe una cuestión mucho menos visible que comienza a preocupar a los responsables de ciberseguridad: la identidad de estos nuevos actores digitales. Cada agente de IA necesita acceder a aplicaciones, consultar bases de datos, utilizar APIs, interactuar con servicios cloud o ejecutar acciones en nombre de una organización. Y para hacerlo necesita credenciales, permisos y privilegios. En otras palabras, necesita una identidad digital. El crecimiento de las identidades no humanas Durante años, las estrategias de gestión de identidades se centraron en empleados, proveedores y clientes. Hoy el escenario es muy diferente. Aplicaciones, robots software, servicios cloud, dispositivos IoT, contenedores y procesos automatizados ya superan ampliamente el número de usuarios humanos en muchas organizaciones. La incorporación masiva de agentes de IA acelerará todavía más esta tendencia. Cada uno de ellos requerirá permisos específicos para consultar información, modificar documentos, lanzar procesos o comunicarse con otros sistemas. Gestionar este ecosistema se convertirá en uno de los grandes retos de la próxima década. Un agente con demasiados privilegios puede convertirse en un riesgo Uno de los principios básicos de la ciberseguridad establece que cualquier identidad debe disponer únicamente de los permisos estrictamente necesarios para desempeñar su función. Este principio de mínimo privilegio resulta especialmente importante cuando hablamos de inteligencia artificial. Si un agente dispone de acceso excesivo, un error de configuración, una vulnerabilidad o un ataque podría permitir movimientos laterales dentro de la organización con consecuencias difíciles de controlar. El riesgo no reside únicamente en un ciberdelincuente, sino también en una automatización mal diseñada. Zero Trust también llega a la inteligencia artificial Los modelos Zero Trust se basan en una premisa sencilla: no confiar automáticamente en ningún usuario, dispositivo o aplicación. Esta filosofía comienza a extenderse también hacia los agentes inteligentes. Cada solicitud deberá autenticarse, autorizarse y registrarse independientemente del lugar desde el que se origine. Además, será necesario revisar continuamente los permisos asignados para adaptarlos a las funciones reales que desempeñe cada agente. La trazabilidad será clave Cuando una inteligencia artificial ejecuta una acción, surge una pregunta fundamental: ¿quién es responsable? Responder a esta cuestión exige disponer de registros completos que permitan conocer qué agente actuó, qué información consultó, qué decisión tomó y qué sistemas modificó. La observabilidad dejará de ser una característica técnica para convertirse en un requisito imprescindible de gobernanza. El nuevo desafío para los responsables de seguridad La llegada de la inteligencia artificial no elimina los principios tradicionales de la ciberseguridad; al contrario, los hace aún más relevantes. La gestión de identidades, el gobierno de accesos privilegiados, la autenticación adaptativa y la monitorización continua serán pilares fundamentales para convivir con agentes capaces de actuar de forma autónoma. En los próximos años, los CISO tendrán que proteger no solo a las personas y los dispositivos, sino también a miles de identidades digitales creadas para que la inteligencia artificial pueda trabajar. La pregunta ya no es cuántos empleados accederán a los sistemas de una empresa, sino cuántos agentes inteligentes lo harán en su nombre.
20 Agosto 2026
Jarana
BMW Group ha nombrado a Carlos Martínez Gil nuevo director de Marketing para España y Portugal, cargo que asumirá el próximo 1 de septiembre. Hasta ahora General Manager de MINI Iberia, Martínez Gil acumula más de 21 años de trayectoria en BMW Group, donde ha desempeñado diferentes responsabilidades en las áreas de ventas, marketing y servicios financieros. En esta nueva etapa liderará la estrategia de marketing de la marca BMW en el mercado ibérico, tomando el relevo de Gonzalo Sanjuán, quien continuará su carrera profesional dentro del grupo como Managing Director de BMW Brasil.
20 Agosto 2026
Suscríbete GRATIS y disfruta de contenido ilimitado sobre ciberseguridad y personas

